国勢調査のデータと R を使って結婚について考える
まず、「国勢調査の配偶関係データを R で取得する」で作成した、都道府県別の婚姻状況データを読み込みます。このデータは、15歳以上の日本の居住者を、都道府県毎、年齢毎、性別毎に、「未婚」「離別」「死別」「配偶関係不詳」「有配偶」に分けて記載しています。一般的には未婚、既婚の2分類を使いますが、国勢調査では婚姻関係を結んだ後の離別(離婚)と死別(配偶者の死亡)も区別しています。
census <- read.csv('prefs.csv')
attach(census)
census$age <- as.integer(sub('歳.*', '', age))
census$area_code <- as.factor(area_code)
census$area <- ordered(area, levels=unique(area))
census$marital_status <- ordered(
  marital_status,
  levels=rev(c('未婚', '離別', '死別', '配偶関係「不詳」', '有配偶'))
)
detach()
このデータは、全人口と、日本人の人口の両方を持っているので、外国人比率も参考までに押さえておきましょう。
国勢調査の配偶関係データを R で取得する
平成27年国勢調査のうち、配偶関係(婚姻関係)のデータを R で取得します。ここでは estatapi パッケージを使います。appId は、e-stat のサイト で事前に取得しておきましょう。
library(estatapi)
statslist %>%
dplyr::filter(grepl('平成27年.*配偶', STATISTICS_NAME)) %>%
select(`@id`, TITLE) %>%
mutate(TITLE=substr(TITLE, 0, 50))
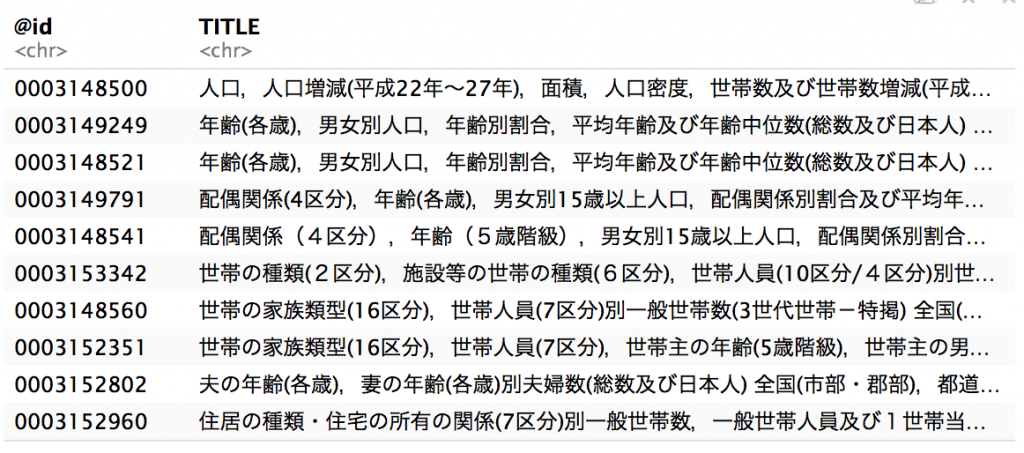
求めるデータの @id が 0003149791 であることがわかったので、メタ情報を取得します。
Dataquest mission 134 - Visualizing Pixar's Roller Coaster
Dataquest の Guided Tour。pandas、matplotlib、seaborn を使って Pixar の映画評価を分析する。
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
%matplotlib inline

pixar_movies = pd.read_csv('PixarMovies.csv')
print(pixar_movies.shape)
pixar_movies.head(3)
(15, 16)
Dataquest mission 113 - FiveThirtyEight college-majors
FiveThrtyEight が提供する college-majors データの分析。
データを読み込む
import pandas as pd

# 全ての年代と、近年のデータをそれぞれ読み込む
all_ages = pd.read_csv('all-ages.csv')
recent_grads = pd.read_csv('recent-grads.csv')
recent_grads.head(5)
深圳という都市
中国本土で最も平均所得が高いといわれるほど経済発展した深圳ですが、1980年代までは寂れた漁村でした。香港に隣接しているという地の利を生かして、鄧小平によって初の経済特区に指定されてから急速に発展した、意図的に作られた近代都市です。
深圳市の面積は約2000k㎡で東京都とほぼ同じ。形も東西に長く、東京都のようです。そこに3000万人超とも言われる人々が暮らしています。全国から人が集まって出来た深圳は、広東省の海側中心部にありながら、広東語ではなく普通語が話されています。香港は広東語ですので、深圳は、広東語圏にぐるっと囲まれた、普通語都市です。
 縮尺を揃えた東京都と深圳市